Grafana + Prometheus: Panduan Monitoring Server Lengkap untuk DevOps
Stack monitoring open-source Prometheus + Grafana: instalasi, konfigurasi metrics, dashboard, alerting, dan best practice observability server.
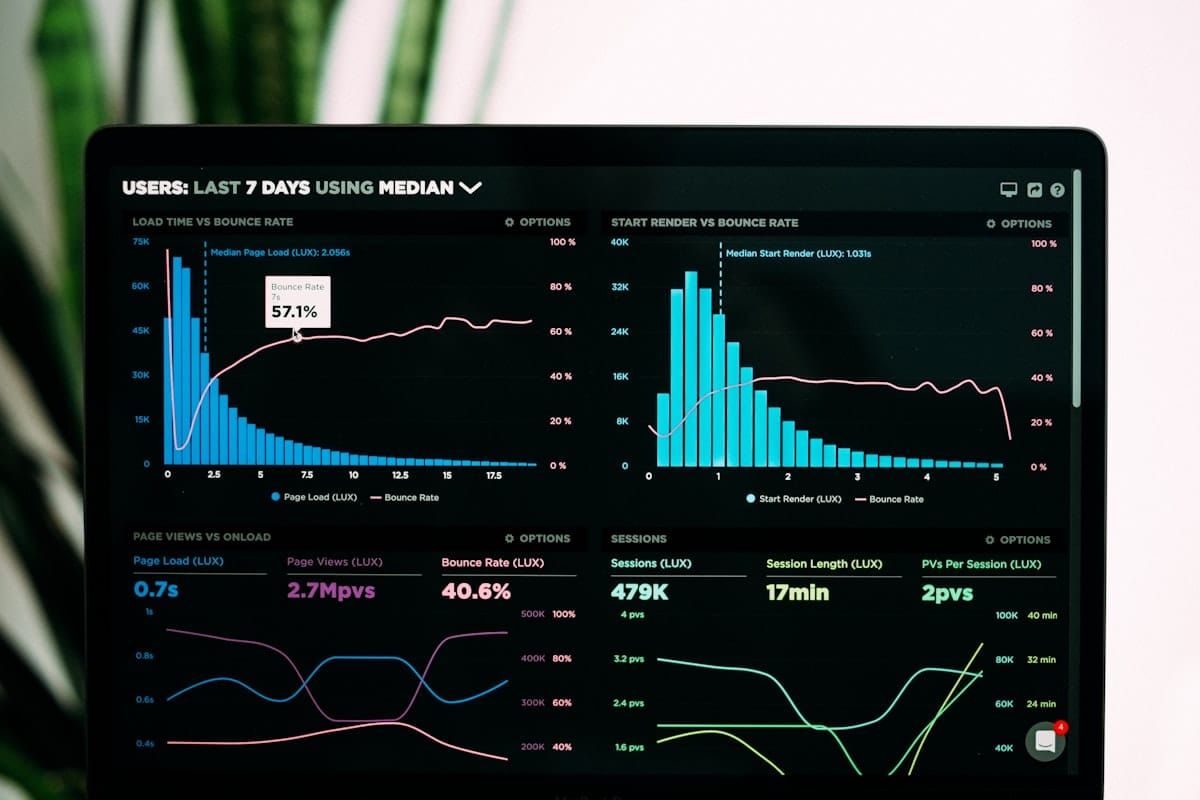
Tanpa monitoring, Anda mengelola server secara buta. Masalah baru terdeteksi setelah user complain — atau lebih buruk, setelah downtime berkepanjangan. Prometheus + Grafana adalah stack monitoring standar industri: open-source, mature, dan memiliki komunitas terbesar. Artikel ini membahas dari instalasi hingga konfigurasi lanjutan.
Kenapa Prometheus + Grafana?
Empat alasan utama stack ini mendominasi:
**Pull Model** — Prometheus menarik (pull) metrics dari target, bukan menunggu target mengirim. Ini memudahkan discovery dan monitoring kesehatan target — jika target mati, metrics berhenti datang, dan Anda langsung tahu.
**Time-Series Database** — Prometheus menyimpan data sebagai time-series dengan label dimensions. Ini memungkinkan query yang sangat fleksibel: rate(http_requests_total{job="api", status="5xx"}[5m]).
**Grafana Visualization** — Dashboard terkustomisasi dengan panel drag-and-drop. Mendukung multiple data sources (Prometheus, Loki, Elasticsearch, CloudWatch, InfluxDB, dll).
**Ecosystem Luas** — Exporters untuk hampir semua aplikasi dan sistem: Node Exporter (Linux), Blackbox Exporter (HTTP/DNS/TCP), Redis Exporter, MySQL Exporter, Nginx Exporter, dan banyak lagi.
Instalasi dan Konfigurasi
Prometheus Server
Download binary dari prometheus.io, ekstrak ke /opt/prometheus. Konfigurasi prometheus.yml: global scrape_interval: 15s. Tambahkan scrape targets: node_exporter (port 9100), aplikasi Anda (port yang expose /metrics), dan Prometheus sendiri (port 9090). Jalankan sebagai systemd service.
Node Exporter
Install di setiap server yang ingin dimonitor. Download binary, jalankan dengan --collector.disable-defaults --collector.cpu --collector.memory --collector.diskstats --collector.filesystem --collector.netdev --collector.loadavg --collector.uptime. Ekspos port 9100, pastikan firewall membuka akses dari Prometheus server.
Grafana
Install dari APT/YUM atau Docker: docker run -d -p 3000:3000 grafana/grafana. Login admin/admin. Add Prometheus data source: URL http://prometheus-server:9090. Import dashboard Node Exporter Full (ID 1860) dari grafana.com.
Metrics Wajib untuk Dimonitor
USE Method (Utilization, Saturation, Errors)
— CPU: utilization (%), load average (saturation), context switches
— Memory: used, available, swap usage/IO, OOM kills
— Disk: usage (%), I/O latency (ms), IOPS, queue depth
— Network: bandwidth (bytes/sec), errors, drops, retransmits
RED Method (Rate, Errors, Duration) untuk Services
— Rate: request per second, writes per second
— Errors: HTTP 5xx rate, exception rate, failed queries
— Duration: p50/p95/p99 latency, query execution time
Alerting dengan Alertmanager
Tentukan threshold untuk setiap metric. Contoh rule:
• InstanceDown: jika up == 0 selama 1 menit → critical alert
• HighCpuUsage: jika cpu > 90% selama 5 menit → warning
• DiskFilling: jika disk_free < 10% → critical alert
• HighErrorRate: jika http_5xx > 5% selama 5 menit → critical
Alertmanager routing: kritis alert → PagerDuty/call; warning → Slack/Telegram; info → email. Jangan kirim semua alert ke semua channel — alert fatigue adalah masalah nyata.
Logging dengan Loki
Loki adalah log aggregation system dari Grafana Labs — seperti Prometheus tapi untuk logs. Kelebihan: label-based indexing (mirip Prometheus), bukan full-text indexing (Elasticsearch). Biaya penyimpanan lebih murah, pencarian lebih cepat untuk filter berbasis label.
Install Promtail (agent) di setiap server untuk mengirim logs ke Loki. Query logs di Grafana dengan LogQL: {job="nginx"} |= "error" | json. Integrasikan logs dengan metrics untuk observability lengkap — misal: lihat logs dari request yang menghasilkan HTTP 5xx.
Tracing dengan Tempo
Untuk observability level mikroskopis: distributed tracing. Grafana Tempo adalah backend tracing yang kompatible dengan Jaeger, Zipkin, dan OpenTelemetry. Gunakan instrumentation library (OpenTelemetry SDK) di aplikasi Anda untuk mengirim spans.
Temukan bottleneck: request 500ms ternyata terdiri dari 50ms di API gateway, 300ms di database query, 50ms di external API call, 100ms di serialisasi response. Tanpa tracing, Anda tidak akan pernah tahu.
Best Practice Production
• Prometheus server: dedicated VM/container, jangan satukan dengan aplikasi
• Retention: 15-30 hari untuk Prometheus, 7-14 hari untuk Loki (atau gunakan object storage)
• High availability Prometheus: install dua instance identik, Grafana bisa query keduanya
• Secure endpoints: Prometheus, Grafana, dan Alertmanager harus dibalik reverse proxy dengan auth
• Dokumentasikan dashboard dan alert rules — 'apa yang dimonitor dan kenapa'
• Regular review: evaluasi apakah alert masih relevan, adakah false positive yang perlu dituning
Kesimpulan
Prometheus + Grafana adalah investasi yang wajib untuk setiap server produksi. Mulai dari Node Exporter untuk metrics dasar, tambahkan exporter spesifik aplikasi, lalu log (Loki) dan tracing (Tempo) untuk observability 360 derajat. Jangan lupa alerting — yang lebih penting dari dashboard adalah notifikasi saat ada masalah. Dashboard cantik tanpa alert hanyalah "post-mortem visualization".


