Observability 2026: Mengapa Monitoring Saja Sudah Tidak Cukup untuk Sistem Modern
Perbedaan fundamental antara monitoring dan observability, mengapa OpenTelemetry menjadi standar industri, dan bagaimana implementasi observability penuh mengubah cara tim engineering mendeteksi dan menyelesaikan insiden di era distributed system.
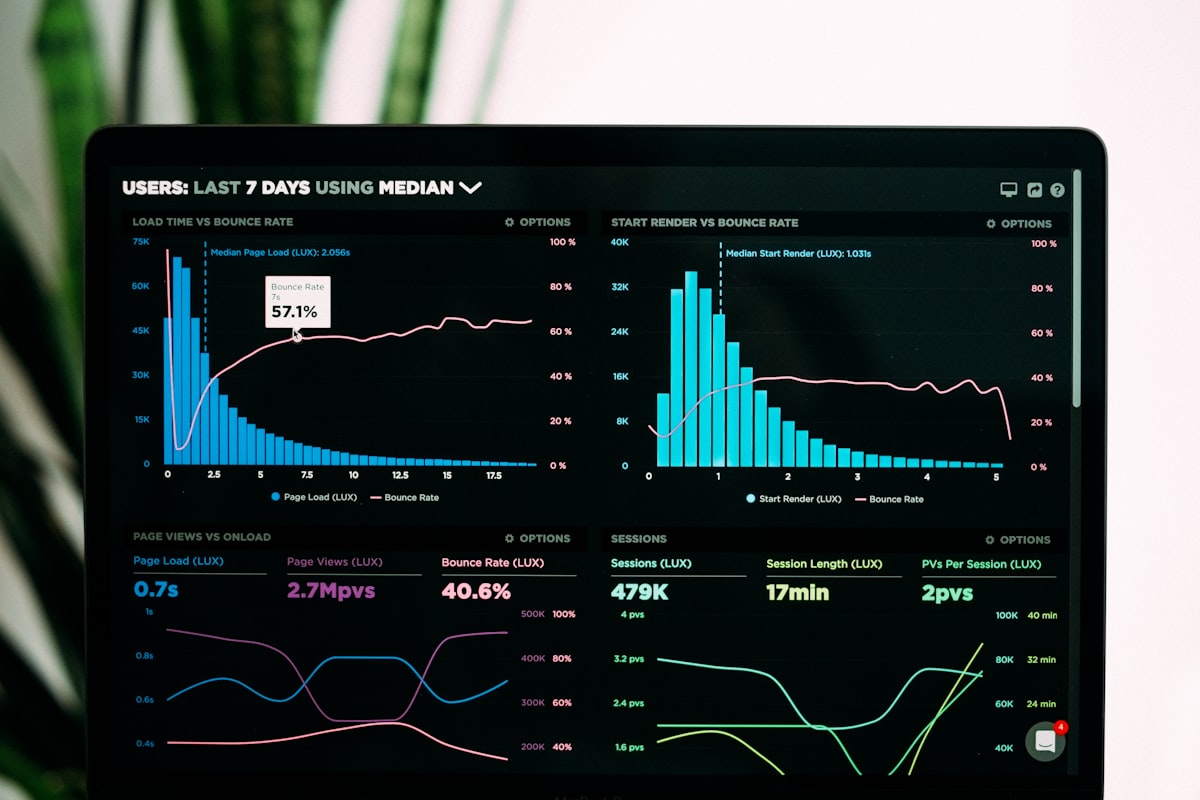
Selama bertahun-tahun, tim engineering mengandalkan monitoring tradisional — metrik CPU, memory usage, request latency, dan error rate — untuk menjaga kesehatan sistem. Pendekatan ini berfungsi dengan baik ketika arsitektur masih monolitik dan failure mode terbatas. Namun lompatan ke microservices, Kubernetes, dan serverless telah memecah asumsi tersebut. Tahun 2026 menandai titik balik: monitoring saja sudah tidak cukup. Observability bukan sekadar buzzword, melainkan kebutuhan survival untuk tim yang mengelola sistem terdistribusi skala besar.
Monitoring vs Observability: Perbedaan Fundamental
Monitoring menjawab pertanyaan "apakah sistem sehat?" dengan metrik yang sudah didefinisikan sebelumnya. Observability menjawab "mengapa sistem tidak sehat?" dengan kemampuan mengekspor state internal sistem melalui telemetry data yang kaya: logs, metrics, dan traces. Perbedaan kunci terletak pada cardinality dan context. Monitoring tradisional menghindari high-cardinality data (user ID, request ID, correlation ID) karena mahal disimpan. Observability modern justru mengandalkan high-cardinality data untuk correlating events across services dalam hitungan detik.
Insight 2026: Sistem yang hanya ter-monitor memungkinkan tim mengetahui apa yang rusak. Sistem yang observable memungkinkan tim mengetahui mengapa dan di mana akar masalah berada — tanpa perlu deploy kode baru atau menambah logging manual.
OpenTelemetry: Standar Universal yang Telah Menang
OpenTelemetry (OTel) telah berevolusi dari project incubating CNCF menjadi standar de facto instrumentasi vendor-neutral. Tahun 2026, mayoritas vendor observability — Grafana, Datadog, New Relic, Honeycomb, Elastic — telah mengadopsi OTel sebagai ingestion layer utama. Keuntungan strategis: tim engineering tidak terikat ke vendor lock-in. Instrumentasi sekali, kirim ke backend manapun.
// Contoh instrumentasi manual OpenTelemetry Go
import (
	"go.opentelemetry.io/otel"
	"go.opentelemetry.io/otel/attribute"
	"go.opentelemetry.io/otel/trace"
)

var tracer = otel.Tracer("order-service")

func ProcessOrder(ctx context.Context, orderID string) error {
	ctx, span := tracer.Start(ctx, "ProcessOrder",
		trace.WithAttributes(attribute.String("order.id", orderID)))
	defer span.End()

	// Business logic di sini
	span.AddEvent("payment.validated")
	return nil
}
OTel Collector berfungsi sebagai observability router: menerima telemetry dari aplikasi, melakukan transformasi (redaksi PII, sampling, enriching dengan metadata Kubernetes), lalu mengekspor ke satu atau multiple backend. Arsitektur ini memisahkan instrumentation concerns dari storage/visualization concerns.
Arsitektur Four Pillars di Era 2026
Model tradisional "Three Pillars" (Logs, Metrics, Traces) telah berkembang menjadi Four Pillars dengan penambahan Continuous Profiling. Profiling continuous (always-on, low-overhead) mengisi celah yang tidak tercapai traces: performa fungsi-level, memory allocation, lock contention, dan CPU hotspots tanpa sampling bias.
- Logs: Structured, correlated via trace ID, high-cardinality attributes
- Metrics: Prometheus-compatible, exemplars linking ke traces
- Traces: Distributed tracing dengan W3C TraceContext propagation
- Profiles: eBPF-based continuous profiling (Parca, Pyroscope, Grafana Pyroscope)
Kombinasi keempat pillar ini memungkinkan investigasi end-to-end: dari alert latency spike → trace request lambat → span database query → profile menunjukkan lock contention di connection pool → fix connection pool sizing.
AI-Assisted Observability: Dari Reactive ke Predictive
Tren terbaru 2026 adalah integrasi LLM ke dalam observability stack. Grafana LLM Plugin, Datadog Watchdog, dan Honeycomb Query Assistant memungkinkan engineer menanyakan pertanyaan natural language: "Mengapa latency p95 naik 40% jam lalu?" Sistem menganalisis traces, logs, metrics, dan deployment events, lalu menyarankan root cause hypothesis beserta runbook relevan.
# Contoh PromQL untuk alert berbasis SLO
# Burn rate alert: error budget consumption > 2% per jam
sum(rate(http_requests_total{job="api",status=~"5.."}[5m]))
/
sum(rate(http_requests_total{job="api"}[5m]))
> 0.02
Namun AI tidak menggantikan expertise domain. Ia mempercepat time-to-hypothesis, bukan time-to-fix. Tim tetap memerlukan runbook, playbook incident response, dan culture blameless postmortem.
Implementasi Praktis: Langkah Pertama Minggu Ini
- Adopsi OpenTelemetry SDK di semua service baru; retrofit service kritis existing
- Deploy OTel Collector sebagai DaemonSet (node-level) dan Deployment (cluster-level) untuk centralized processing
- Standardisasi semantic conventions: gunakan
service.name,service.namespace,deployment.environmentkonsisten - Enable exemplars di Prometheus untuk linking metrics ke traces
- Integrasi continuous profiling via eBPF agent (zero-code instrumentation)
- Definisi SLO/SLI berbasis user journey, bukan infrastructure metrics
Observability 2026 bukan tentang tool, melainkan tentang telemetry hygiene dan investigative culture. Tim yang berinvestas pada fondasi OTel hari ini akan menghabiskan 80% waktu mengembangkan fitur, bukan mencari log di seluruh cluster saat insiden terjadi.


